In Diskussionen über KI-Architektur werden gerade drei Begriffe gehandelt, als stünden sie im selben Regal: RAG, GraphRAG und Knowledge Graph. Man soll sich für einen entscheiden. Das führt in die Irre, weil die drei auf verschiedenen Ebenen liegen.
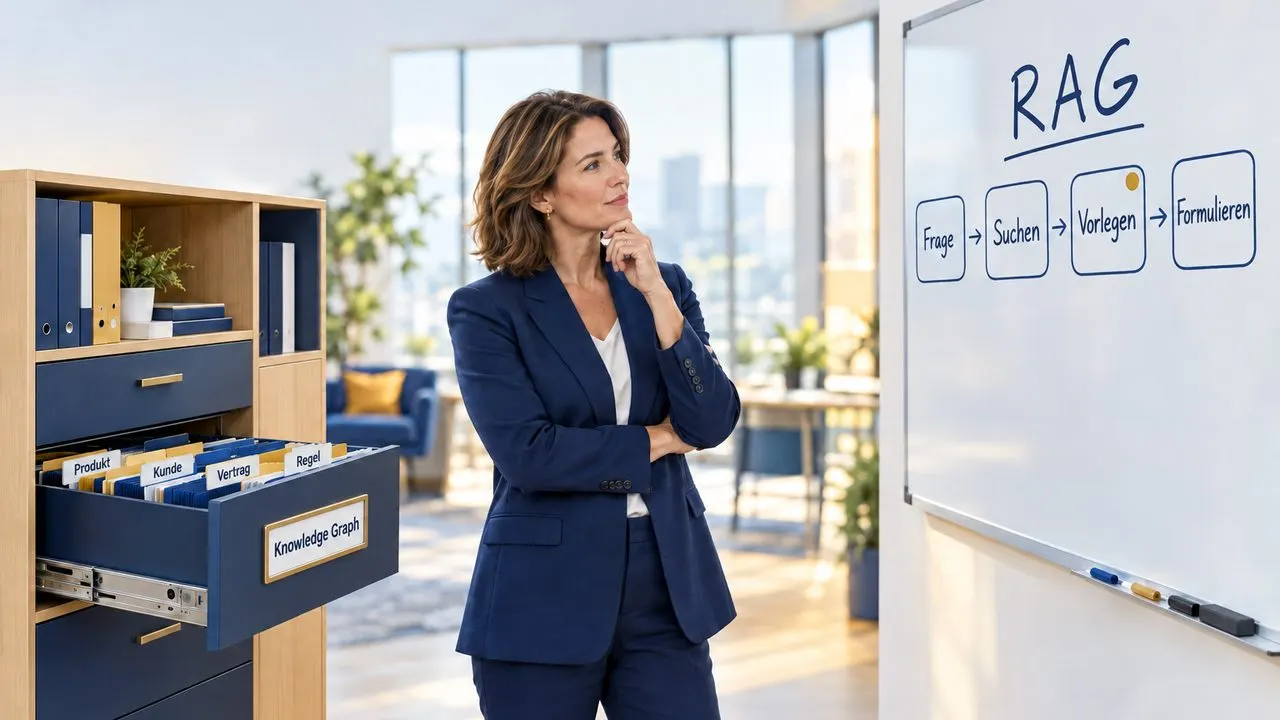
Ein Knowledge Graph ist eine Art, Wissen zu speichern. RAG ist ein Ablauf, mit dem ein Sprachmodell an Wissen kommt. GraphRAG ist eine Variante dieses Ablaufs, bei der ein Sprachmodell aus deinen Dokumenten zuerst einen Graphen baut. «Knowledge Graph statt RAG» vergleicht also einen Aktenschrank mit einem Arbeitsablauf.
Für die Architekturentscheidung zählt vor allem, wer am Ende die Antwort schreibt: das Sprachmodell oder deine Daten. Davon hängen die Haftung ab, die Nachprüfbarkeit und die Frage, ob deine Daten überhaupt durch das Modell laufen.
RAG: erst nachschlagen, dann formulieren
RAG steht für Retrieval-Augmented Generation. Der Begriff stammt aus einem Forschungspapier von Patrick Lewis und Kollegen aus dem Jahr 2020.
Deine Dokumente werden in Abschnitte zerlegt, und jeder Abschnitt bekommt eine Art Bedeutungskoordinate, ein sogenanntes Embedding. Stellt jemand eine Frage, sucht das System die Abschnitte, deren Bedeutung der Frage am nächsten liegt. Diese Abschnitte bekommt das Sprachmodell zusammen mit der Frage vorgelegt, und es formuliert daraus die Antwort.
Das passt zu einer Frage wie «Welche Kündigungsfrist gilt im Rahmenvertrag mit Lieferant A?». Die Antwort steht in einem Absatz, der Absatz ähnelt der Frage, und die Suche findet ihn.
Wo RAG stark ist:
Es arbeitet mit Text, wie er ist: Handbücher, Richtlinien, Verträge, Tickets. Niemand muss vorher etwas modellieren.
Es ist schnell aufgebaut, und die Stellschrauben für gute Treffer sind bekannt. Welche das sind, steht im Artikel über Halluzinationen bei Geschäftsdaten.
Die Fundstelle lässt sich zur Antwort anzeigen. Wer liest, kann nachprüfen.
Ändert sich ein Dokument, wird nur dieses neu eingelesen.
Wo RAG an Grenzen stösst:
Die Suche kennt keine Beziehungen zwischen Dokumenten. Ob ein Vertrag und die Mitteilung über einen Lieferantenwechsel zusammengehören, weiss sie nicht. Sie findet beide nur, wenn beide der Frage ähneln.
Fragen über den ganzen Bestand scheitern. «Welche Themen ziehen sich durch alle Kundenbeschwerden des letzten Jahres?» hat keinen Absatz, der ihr ähnelt. Microsoft Research hat 2024 beschrieben, dass klassisches RAG bei solchen Fragen an einen ganzen Textbestand versagt. Gefragt ist dort eine Zusammenfassung, und die Suche liefert Fundstellen.
Zählen über den ganzen Bestand funktioniert nicht. «Wie viele Verträge laufen im dritten Quartal aus?» braucht alle Verträge. Die Suche liefert die ähnlichsten paar, und die Zahl in der Antwort schreibt das Modell auf Basis dieser Auswahl.
Das Modell schreibt die Antwort. Es kann richtig gefundenes Material falsch wiedergeben. RAG senkt das Risiko erfundener Antworten, beseitigt es aber nicht. Wer haftet, wenn das beim Kunden passiert, steht in «Wenn dein Chatbot lügt, haftest du».
Einsatzgebiete: interne Wissensdatenbanken, Support auf Basis von Handbüchern, das Durchsuchen von Richtlinien und Verträgen. Überall dort, wo die Antwort eine Textstelle ist und ein Mensch sie liest, bevor jemand danach handelt.
GraphRAG: RAG mit einem Graphen, den das Modell selbst baut
GraphRAG kommt von Microsoft Research und wurde 2024 als Forschungspapier und als Open-Source-Projekt veröffentlicht. Vor der ersten Frage laufen zwei Vorstufen.
Zuerst liest ein Sprachmodell alle Dokumente und zieht die Dinge heraus, die darin vorkommen, also Personen, Firmen, Produkte und Orte, samt den Beziehungen zwischen ihnen. Daraus entsteht ein Graph. Dann fasst das System eng verbundene Dinge zu Gruppen zusammen und lässt das Modell für jede Gruppe vorab eine Zusammenfassung schreiben. Bei einer Frage über den ganzen Bestand setzt das Modell die Antwort aus diesen Zusammenfassungen zusammen.
Damit ist GraphRAG eine Form von RAG. Der Graph kommt als Fundus hinzu, aus dem das Modell sein Material bekommt. Die Antwort schreibt weiterhin das Modell.
Wo GraphRAG stark ist:
Es beantwortet Fragen über einen ganzen Textbestand: Themen, Muster, Verbindungen über viele Dokumente hinweg. Dafür wurde es gebaut, und in Microsofts eigener Auswertung schneidet es dabei deutlich besser ab als klassisches RAG.
Es macht Zusammenhänge sichtbar, die in keinem einzelnen Dokument stehen.
Wo GraphRAG an Grenzen stösst:
Der Aufbau ist teuer. Das Modell liest den ganzen Bestand und schreibt die Zusammenfassungen, bevor die erste Frage gestellt wird. Microsoft schreibt im eigenen Repository, das Indexieren könne teuer werden, und rät, klein anzufangen. Ende 2024 hat Microsoft mit LazyGraphRAG eine Variante vorgestellt, die diese Vorab-Zusammenfassungen weglässt. Nach Microsofts eigener Angabe kostet deren Indexierung so viel wie bei Vektor-RAG und 0,1 Prozent der vollen GraphRAG-Indexierung.
Den Graphen baut das Modell. Was es beim Herausziehen falsch versteht, wird zu einer Beziehung, die niemand geprüft hat und die danach genauso belastbar aussieht wie eine richtige.
Das Modell schreibt weiterhin die Antwort. Am Risiko einer falsch formulierten Antwort ändert der Graph nichts.
Microsoft nennt GraphRAG im Repository ein Forschungsprojekt, das weitgehend im Wartungsmodus ist, und den Code eine Demonstration, kein offiziell unterstütztes Produkt. LazyGraphRAG hat Microsoft nach eigener Angabe inzwischen in Microsoft Discovery und Azure Local eingebaut.
Einsatzgebiete: die Auswertung grosser Dokumentbestände, bei der ein Mensch das Ergebnis als Ausgangspunkt nimmt, etwa für eine Recherche, die Analyse von Feedback oder Berichten oder die Einarbeitung in einen fremden Bestand. Für Antworten, nach denen jemand direkt handelt, gelten dieselben Vorbehalte wie bei RAG.
Knowledge Graph: Wissen als Dinge und Beziehungen
Ein Knowledge Graph speichert Wissen als Dinge und ihre Beziehungen. Bekannt gemacht hat den Begriff Google im Jahr 2012, mit der Formel «things, not strings». Die Suche sollte Dinge verstehen, statt Zeichenketten zu vergleichen.
Ein Knoten ist ein Ding: ein Produkt, ein Kunde, ein Vertrag, eine Regel. Eine Kante ist eine Beziehung zwischen zwei Knoten: ersetzt, gehört zu, ist erlaubt für, gilt ab. Gespeichert wird das in einer Graphdatenbank oder, wie bei meinem eigenen Wissensgraphen, als Ordner mit Textdateien, die aufeinander verweisen.
Ein Knowledge Graph braucht kein Sprachmodell. Er ist ein Speicher, so wie eine Datenbank. Zum KI-Ansatz wird er erst dadurch, wie ein Sprachmodell ihn nutzt, und dafür gibt es zwei Wege.
Als Material für das Modell. Passende Teile aus dem Graphen werden dem Modell vorgelegt, und es formuliert die Antwort. Das ist wieder RAG, mit denselben Grenzen.
Als Ziel einer Abfrage. Das Modell übersetzt die Frage in eine Abfrage, und die Antwort kommt aus den Daten. Das Modell beantwortet nichts selbst.
Den zweiten Weg baue ich. In einem Shop-Prototyp sieht das so aus: Jemand fragt nach den Zutaten für ein Gericht und danach nach einer veganen Alternative zu einer davon. Das Modell erkennt, welche Zutat gemeint ist. Der Graph enthält die Regel, aus welcher Kategorie in welche gewechselt werden darf. Die Produktsuche liefert die Artikel, die es im Sortiment tatsächlich gibt. Kein Produkt in der Antwort stammt aus dem Gedächtnis des Modells.
Wo dieser Weg stark ist:
Jede Antwort ist nachprüfbar. Die Abfrage, die zu ihr geführt hat, lässt sich ausdrucken und kontrollieren.
Es gibt keinen erfundenen Antworttext, weil das Modell die Inhalte nicht formuliert.
Deine Daten laufen nicht durch das Modell. Es sieht die Frage, die Daten bleiben im Index.
Regeln, Filter, Zählen und Berechtigungen sind exakt, weil eine Datenbank sie ausführt und kein Sprachmodell sie schätzt.
Regeln sind lesbar und versionierbar. Ein Eintrag wie «Hafermilch darf Kuhmilch ersetzen» wird von einer Fachperson freigegeben und lässt sich zurücknehmen.
Wo er an Grenzen stösst:
Jemand muss das Wissen modellieren und pflegen. Ein Sprachmodell kann Entwürfe liefern, freigeben muss ein Mensch, der das Fach kennt. Wie das bei einem grossen Sortiment gehen kann, beschreibt der Artikel zur Produktsuche.
Er beantwortet nur, was in den Daten steht. Einen flüssigen Absatz aus dem Nichts gibt es nicht. Bei einer Bestellung ist das gewollt, bei der Frage nach dem Sinn einer Richtlinie fehlt dann die Antwort.
Für Wissen, das nur als Fliesstext existiert, passt er schlecht. Ein Handbuch in Knoten und Kanten zu zerlegen, kostet viel und verliert Nuancen.
Der Übersetzungsschritt kann danebenliegen. Versteht das Modell die Frage falsch, baut es die falsche Abfrage. Diesen Fehler sieht man, weil die Abfrage vorliegt.
Einsatzgebiete: Produktkataloge und Sortimente, Regeln und Berechtigungen, Konfigurationen, Stammdaten und alles, wofür du belegen musst, woher eine Antwort kommt. Überall dort, wo eine falsche Antwort Geld kostet oder eine Haftung auslöst.
Die drei im Vergleich
| RAG | GraphRAG | Knowledge Graph mit Abfrage | |
|---|---|---|---|
| Was es ist | Ein Ablauf: suchen, dann formulieren | RAG mit einem Graphen, den das Modell baut | Ein Speicher für Dinge und Beziehungen, den das Modell abfragt |
| Wer die Antwort schreibt | Das Modell | Das Modell | Die Daten |
| Stark bei | Antworten, die in einer Textstelle stehen | Fragen über einen ganzen Textbestand | Regeln, Filtern, Zählen, Nachweispflicht |
| Schwach bei | Zusammenhängen, Zählen, Fragen über alles | Kosten, ungeprüften Beziehungen | Wissen, das nur als Fliesstext existiert |
| Aufwand vor dem Start | Gering bis mittel | Hoch, vor allem Rechenkosten | Hoch, vor allem Fachwissen und Pflege |
| Erfundene Antworten | Seltener, nicht ausgeschlossen | Seltener, nicht ausgeschlossen | Kein Antworttext vom Modell, falsche Abfragen bleiben möglich |
Drei Fragen für die Entscheidung
Wo steht die Antwort? Steht sie in einer Textstelle, reicht RAG. Ist sie über viele Dokumente verteilt und gefragt ist ein Überblick, kommt GraphRAG in Frage. Steckt sie in strukturierten Daten und Regeln, gehört sie in eine Abfrage.
Was kostet eine falsche Antwort? Liest eine Mitarbeiterin die Antwort und prüft sie, ist ein formulierendes Modell vertretbar. Geht die Antwort direkt an einen Kunden oder löst sie eine Bestellung aus, sollte sie aus den Daten kommen.
Wer pflegt das Wissen danach? RAG braucht jemanden, der die Dokumente aktuell hält. Ein Knowledge Graph braucht jemanden, der Regeln freigibt. Gibt es diese Person nicht, ist die Entscheidung gefallen, bevor die Technik zur Sprache kommt.
Die Bausteine schliessen sich nicht aus. Ein System kann einen Graphen für Regeln, eine Suche für den Katalog und RAG für die Handbücher nutzen. Welche Kombination passt, ergibt sich aus den Fragen, die dein System beantworten soll.
Welcher Ansatz passt zu deinen Daten?
Wenn du gerade vor dieser Entscheidung stehst oder ein RAG-Projekt hast, das nicht liefert, was es soll, lass uns darüber sprechen. Bring zwei, drei echte Fragen mit, die dein System beantworten soll, und eine Vorstellung davon, was eine falsche Antwort kostet. Damit klären wir im Gespräch, welcher Ansatz passt. Buch unten einen Termin.