Am 22. Oktober hat Anthropic gezeigt, wie Claude zusammen mit der Firma Theorem formale Beweise für echte Software schreibt. Für 239 Einstiegspunkte in 123 Open-Source-Bibliotheken ist jetzt bewiesen, dass sie bei keiner Eingabe unter 64 MB abstürzen. In dem Beitrag füllt sich ein Labyrinth Gang für Gang mit Grün.
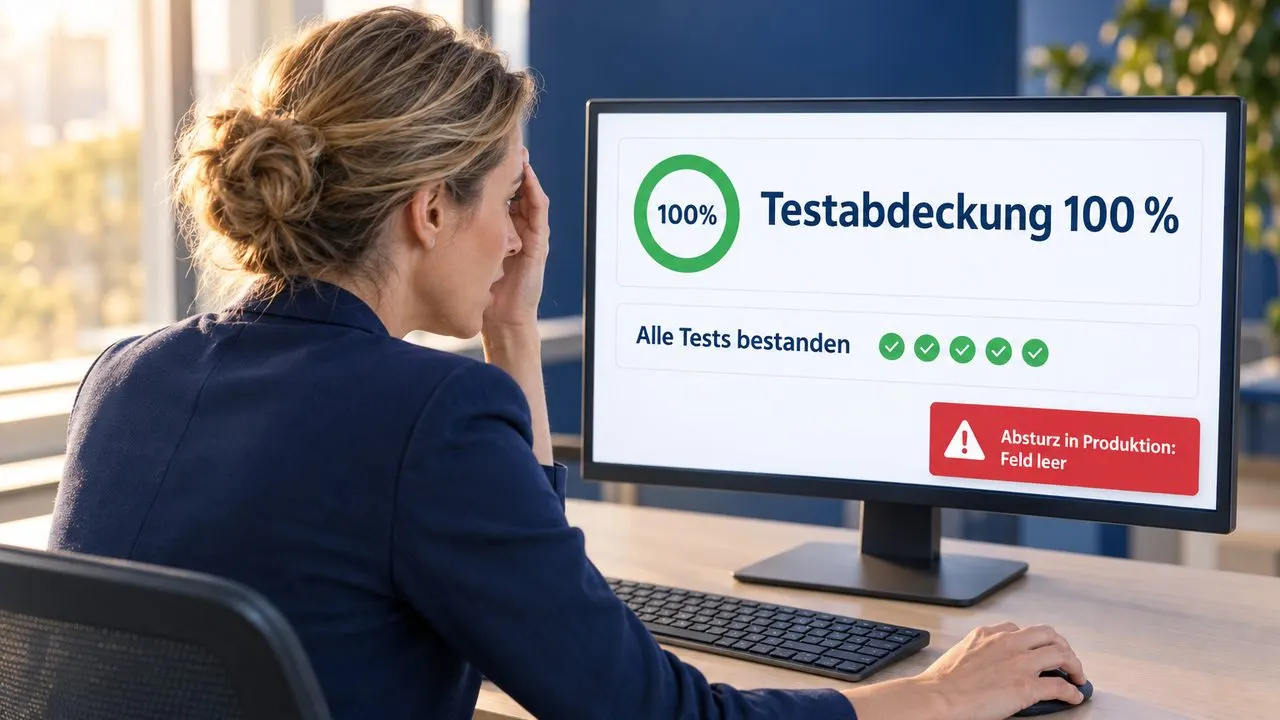
Das Bild lädt zu einer naheliegenden Lesart ein: Die KI geht jeden Zweig des Codes mit Unit-Tests ab, am Ende stehen 100 Prozent Testabdeckung, und offen bleibt nur noch, ob der Code die Spezifikation erfüllt. Diese Lesart ist falsch, und zwar genau umgekehrt. Nach einem Beweis ist entschieden, dass der Code die Spezifikation erfüllt. Offen bleibt, ob die Spezifikation das Richtige verlangt. Und 100 Prozent Testabdeckung beweisen nichts über die Eingaben, die kein Test ausprobiert hat.
Dieselbe Verwechslung steckt im Satz «die KI schreibt die Tests gleich mit». Der Unterschied lässt sich an einem einzigen Einzeiler zeigen.
Ein Einzeiler, drei Arten zu prüfen
Ein Formular kennt den Platzhalter «n/a» für «keine Angabe». Diese Funktion erkennt ihn. So eine Zeile schreibt eine KI genauso wie ein Mensch, ohne lange nachzudenken:
public static bool IsNotSpecified(string value)
    => value.Trim() == "n/a";
Stufe 1: der Beispieltest. Er prüft ein Beispiel, das sich jemand ausgedacht hat:
[Fact]
public void Recognises_the_marker()
    => Assert.True(AnswerValues.IsNotSpecified("n/a"));
Der Test ist grün. Das Abdeckungswerkzeug meldet 100 Prozent der Zeilen und 100 Prozent der Zweige. Trotzdem stürzt die Funktion ab, sobald ein Feld leer aus der Datenbank kommt und value gleich null ist. Abdeckung misst, dass eine Zeile gelaufen ist. Ob die Zeile für alle Eingaben stimmt, misst sie nicht.
Stufe 2: der Eigenschaftstest. Statt eines Beispiels formulierst du eine Regel: Für jeden Text, und auch für gar keinen, wirft die Funktion keinen Fehler. Ein Werkzeug wie FsCheck erzeugt dafür Hunderte zufälliger Eingaben:
[Property]
public Property Never_throws_including_null()
    => Prop.ForAll(
        ArbMap.Default.GeneratorFor<string>().OrNull().ToArbitrary(),
        value => { AnswerValues.IsNotSpecified(value); });
Nach wenigen Durchläufen meldet der Test eine NullReferenceException. Entscheidend ist der Zusatz OrNull(). Ohne ihn erzeugt FsCheck in Version 3.6 kein null: Unter 2000 erzeugten Eingaben ist kein einziges, und der Test bleibt grün. Auch ein Eigenschaftstest prüft nur den Wertebereich, den du ihm ausdrücklich gibst.
Stufe 3: der Beweis. Ein Beweis führt nichts aus. Er zeigt für alle Eingaben auf einmal, dass die Regel gilt. Die einfachste Form steckt schon in deinem Compiler. Schaltest du in C# die Nullable Reference Types ein (in TypeScript heisst das strictNullChecks), musst du dich entscheiden:
- Steht in der Signatur
string, meldet der Compiler jeden Aufrufer, dernullübergeben könnte (Warnungen CS8604 und CS8625). - Steht dort
string?, meldet ervalue.Trim()als «Dereferenzierung eines möglichen Nullverweises» (Warnung CS8602).
Das gilt in jedem Projekt, in dem du es einschaltest, bei jedem Build und ohne einen einzigen Test. Lücken hat dieser Beweis trotzdem: Mit dem Operator ! schaltet ein Entwickler die Prüfung bewusst ab, und was ein Deserialisierer zur Laufzeit in ein Objekt schreibt, sieht der Compiler nicht. Für reichere Regeln, etwa «diese Rabattberechnung ergibt nie einen negativen Preis», gibt es Werkzeuge wie Dafny. Du schreibst die Regel hin, und das Werkzeug beweist sie oder zeigt dir, an welcher Stelle der Beweis scheitert.
Was Anthropic tatsächlich gemacht hat
Claude hat keine Tests laufen lassen. Claude hat Beweise geschrieben, insgesamt rund 180 Millionen Zeilen in der Beweissprache Rocq. Ein Beweisprüfer kontrolliert jeden davon. Der KI muss niemand vertrauen, nur dem Prüfer und der Regel.
Die Regel war bescheiden: Das Programm stürzt nicht ab, für jede Eingabe unter 64 MB, ohne Speicherfehler und ohne verletzte Zusicherung. Sie gilt unter Annahmen, die Anthropic offenlegt: ein einzelner Thread, ein RISC-V-Prozessor, Linux, ein festes Speicherbudget. Wo ein vorhandener Test mehr prüfte, etwa dass Komprimieren und Entpacken wieder die Originaldaten ergibt, ist auch das bewiesen.
Beim Beweisen fand Claude Fehler, die jahrelang unentdeckt geblieben waren. Einer zeigte sich nur bei Eingaben um 20 MB mit einem seltenen Aufbau. Fuzzer, die solche Zufallseingaben erzeugen, arbeiten laut Anthropic typischerweise mit höchstens 1 MB.
Anthropic schreibt selbst, dass «formal verifiziert» nicht «fehlerfrei» heisst. Der Beweis zeigt, dass der Code die Regel einhält. Ob die Regel die richtige ist und ob das Modell von Prozessor und Betriebssystem der Wirklichkeit entspricht, beweist er nicht.
Was in deinem Projekt funktioniert
Null-Sicherheit über den Compiler. Das kostet einmal das Abarbeiten der Warnungen, Projekt für Projekt. Danach schliesst jeder Build eine ganze Fehlerklasse aus.
Kleine Funktionen ohne Seiteneffekte. Preisregeln, Rabatte, Zinsen, Parser, Filter, Statistik. Dort lässt sich die Regel klar hinschreiben, ein Eigenschaftstest ist schnell gebaut, und ein Beweis ist machbar.
Dieselbe Regel an mehreren Orten. Ein Anwender definiert einen Filter einmal. Die Datenbank führt ihn als SQL aus, der Browser als JavaScript, das BI-Werkzeug in seiner eigenen Sprache. Das sind drei handgeschriebene Übersetzungen derselben Regel. Kann eine davon einen regulären Ausdruck nicht übersetzen und lässt ihn stillschweigend weg, zeigt derselbe Bericht andere Zahlen, je nachdem, wo er gerechnet wurde. Ein Test pro Variante übersieht das leicht, weil jede Variante für sich plausible Zahlen liefert. Die Regel dagegen ist einfach: Alle Übersetzungen liefern für jede Bedingung und jeden Datensatz dasselbe Ergebnis. Als Test schickst du zufällige Bedingungen und Datensätze durch alle Varianten und vergleichst.
Abläufe mit Nebenläufigkeit. Ein Versand soll jede Einladung genau einmal verschicken. Das übliche Muster lautet: prüfen, ob schon gesendet, senden, als gesendet markieren. Stürzt der Prozess zwischen Senden und Markieren ab, sendet der nächste Versuch erneut. Holen sich zwei Prozesse gleichzeitig dieselbe Nachricht, können beide durch die Prüfung kommen. Solche Abfolgen findet ein Modellprüfer wie P in einem kleinen Modell des Ablaufs, bevor sie in Produktion auftreten. Er zwingt dich auch zu einer Entscheidung, die oft niemand bewusst getroffen hat: Bei E-Mail lässt sich «genau einmal» nicht garantieren, nur «höchstens einmal» oder «mindestens einmal».
Was nicht funktioniert
Eine ganze Geschäftsanwendung beweisen wie Anthropic. Anthropic hat kompilierten Maschinencode gegen ein formales Modell von Prozessor und Linux bewiesen. Für .NET- und Java-Laufzeiten, Browser und Cloud-Dienste gibt es kein solches Modell, das du heute im Projekt einsetzen kannst.
Code, den deine Kunden selbst schreiben. Skripte, Formeln, Plugins. Kein Beweis sagt etwas über Code, den es beim Beweisen noch nicht gab.
Die falsche Regel. Ein Beweis bestätigt die Regel. Ob sie gewollt ist, entscheidet ein Mensch.
KI-generierte Tests bis 100 Prozent Abdeckung. Schreibt dieselbe KI aus demselben Verständnis den Code und die Tests, prüfen die Tests, was der Code tut, mitsamt seinen Fehlern. Liest sie den Erwartungswert aus dem Code ab, wird der Fehler zum Sollwert. Die Abdeckung zeigt dann nur, dass jede Zeile einmal gelaufen ist.
Was du ab morgen tun kannst
- Stell den Compiler scharf. Nullable in C#,
strictin TypeScript, Projekt für Projekt und zuerst als Warnung. - Schreib für Funktionen, deren Fehler niemand sieht, Regeln statt Beispiele. Berechnungen, Filter, Datenschutzregeln. Nenn den Wertebereich ausdrücklich:
null, leer, Grenzwerte, sehr grosse Eingaben. - Teste jede Regel, die an mehreren Orten implementiert ist, gegen sich selbst. Zufällige Eingaben durch alle Varianten, gleiche Ergebnisse erwartet.
- Mach die Tests zum Gate vor dem Merge. Ein Test, der erst am nächsten Morgen rot wird, meldet den Fehler, verhindert ihn aber nicht.
- Lass die KI Tests und Beweise schreiben, aber nicht die Regel festlegen. Die Regel legt ein Mensch fest oder prüft sie, zum Beispiel die QA. Dann prüft der Beweisprüfer den Code gegen eine Regel, die nicht von derselben KI stammt.
Welche weiteren Leitplanken es braucht, wenn irgendwann niemand mehr den Code liest, steht in «Kein Mensch liest mehr den Code. Welche Guardrails braucht es dann?».
Wenn du wissen willst, welche Stufe sich in deinem Code wo lohnt, buch unten einen Termin.