Die KI arbeitet über Nacht gegen Tests, die vorher ein Mensch geprüft hat, und ist am nächsten Morgen fertig. Wie es so weit kommt, habe ich in «Mit KI wird dein Product Owner zum Bottleneck» beschrieben.
Ist das Ergebnis fertig, muss der Mensch den Code überprüfen. So ist das heute, und ich habe noch kein Unternehmen gesehen, in dem das nicht mehr der Fall ist.
An der R&D-Konferenz von Kontrapunkt Technology in Frankfurt hat ein R&D-Manager dazu eine interessante Frage gestellt: Muss der Mensch den Code überhaupt noch verstehen? Braucht es den Code eigentlich noch?
Gemeint war nicht, dass der Code verschwindet. Er bleibt als Zwischenschritt, aus dem das Kompilat entsteht. Aber kein Mensch liest ihn mehr, auch nicht im Review. Mit dem Quellcode arbeitet nur noch die KI. Gefragt hat er das mit Blick auf die Effizienz, und eine Antwort gibt es darauf noch nicht.
Durchdenken lässt sich das Szenario aber schon heute. Dann lautet die Frage: Welche Guardrails müssen her, damit man auf den Menschen als Code-Reviewer verzichten kann?
Was wegfällt
Sind Coding Styles überhaupt noch wichtig, wenn Menschen den Code nicht mehr bearbeiten? Was nur der Lesbarkeit für Menschen dient, verliert seinen Zweck. Die Struktur bleibt, denn kleine Einheiten und klare Schnittstellen braucht auch die KI.
Code-Ownership fällt weg. Niemand ist mehr der, der das Modul kennt. Das Wissen über das System muss in Anforderungen, Tests und festgehaltenen Entscheidungen liegen, nicht in Köpfen.
Und mit dem Review fällt alles weg, was der Reviewer nebenbei geprüft hat, ohne dass es irgendwo stand. Genau das müssen die Guardrails auffangen.
Welche Guardrails es braucht
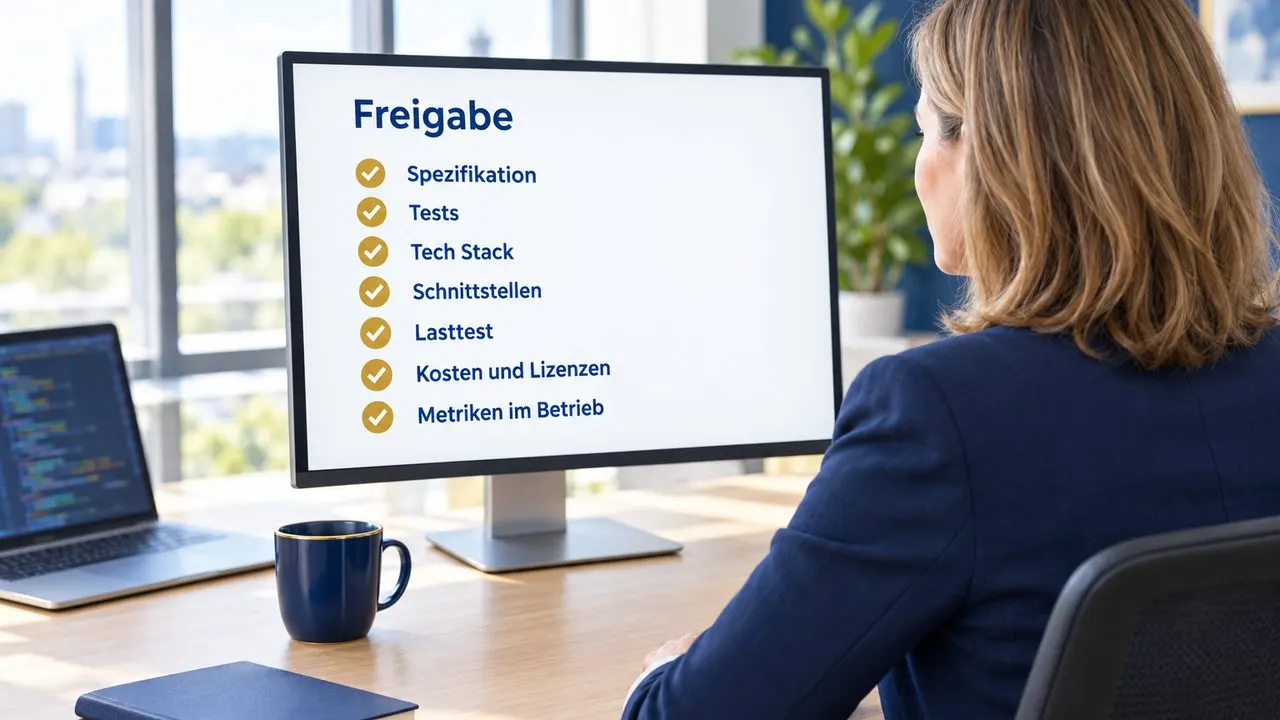
Eine ganz genaue Spezifikation. Der Reviewer prüft heute gegen sein eigenes Verständnis der Anforderung. Ohne ihn zählt nur noch, was in der Spezifikation steht. Lücken füllt die KI mit Mutmassungen.
Tests, die das Verhalten vollständig festhalten. Alles, was kein Test festhält, ist für die KI frei. Bei jeder Änderung kann sich das Verhalten ausserhalb der Tests verschieben, und niemand merkt es. Die Testabdeckung wird damit zur eigentlichen Spezifikation. Ob die Tests etwas taugen, lässt sich prüfen: Ein Mutationstest baut absichtlich Fehler in den Code ein und schaut, ob die Tests sie finden.
Schutz gegen Austricksen. Die Einchecksperre schützt die Tests vor Änderungen, denn jede Änderung an den Tests sieht der Mensch beim Einchecken. Trickst die KI einen Test im Code aus, statt ihn zu erfüllen, fällt das ohne menschlichen Leser nur noch auf, wenn es Tests gibt, welche die KI nicht kennt, oder eine zweite KI, die den Code prüft. Dass aktuelle Modelle so etwas tun, hat METR 2025 dokumentiert.
Ein festgelegter Tech Stack. Der Architekt legt fest, mit welchen Technologien und Bibliotheken gebaut wird und wie die Teile voneinander abhängen dürfen. Eine automatische Prüfung bricht ab, wenn die KI davon abweicht. Ist der Tech Stack nicht festgelegt, füllt die KI auch diese Lücke mit einer Mutmassung.
Gute Schnittstellenbeschreibungen. Jede Komponente hat einen Vertrag, und automatische Tests prüfen, ob sie ihn einhält. Der Mensch versteht das System dann über die Schnittstellen statt über den Code.
Non-Functional Requirements als Messlatte. Ob eine Entkopplung über eine Queue fehlt, sieht heute vielleicht noch jemand im Code-Review. Ohne Reviewer zeigt es nur noch ein Lasttest mit festen Grenzwerten für Durchsatz und Antwortzeiten.
Kosten und Lizenzen. Irgendwer muss festlegen, unter welchen Bedingungen und zu welchen Kosten das Neue wirtschaftlich zu betreiben ist. Das ist FinOps, und da spielt der Tech Stack wieder hinein. Redis oder Valkey, SQL Server oder Postgres: Das eine bringt Lizenzgebühren oder Lizenzauflagen mit, das andere nicht. Bei AWS ist ElastiCache mit Valkey laut AWS 20 Prozent günstiger als mit den anderen Engines, in der Serverless-Variante 33 Prozent günstiger als mit Redis. Eine automatische Lizenzprüfung verhindert, dass die KI eine Abhängigkeit einschleppt, deren Lizenz niemand freigegeben hat.
Metriken im Betrieb, über welche die KI wacht. Die KI beobachtet im Betrieb festgelegte Metriken. Erkennt sie eine Anomalie, greift sie automatisch ein und verbessert. Die Verbesserung läuft dabei durch dieselben Guardrails wie jede andere Änderung.
Ein Nachweis für die Freigabe. Statt des Code-Diffs prüft der Mensch den Test-Diff und den Nachweis, welche Kriterien vereinbart waren, welche Prüfungen gelaufen sind und mit welchem Ergebnis.
Sicherheit gehört ebenfalls auf diese Liste. Sie bekommt einen eigenen Artikel.
Braucht es den Human in the Loop dann noch?
Er verschiebt sich an die Ränder. Vorne stehen Spezifikation, Tech Stack, Kosten, Testkriterien und die Metriken für den Betrieb, hinten die Freigabe. Dazwischen und im Betrieb dreht die KI allein, und die Einchecksperre bleibt.
Ganz weg fällt er nicht, weil jemand die Folgen tragen muss. Wer entscheidet, wer prüft und wer die Folgen trägt, sind drei verschiedene Fragen. Prüfen kann die KI. Die Folgen tragen kann sie nicht. Wer freigibt, muss den Code nicht lesen, aber er muss die Kriterien und den Nachweis verantworten können.
Wie die Arbeitsteilung aussieht
Die Rolle des Entwicklers spaltet sich. Nach oben geht sie in die Architektur, zur Seite in die Prüfung. Das Implementieren übernimmt die KI. Jede Guardrail braucht einen Besitzer:
- Der PO verantwortet die Spezifikation.
- Die QA verantwortet die Tests und den Schutz gegen Austricksen.
- Der Architekt verantwortet Tech Stack, Schnittstellen, Non-Functional Requirements und FinOps, also auch die Entscheidung für oder gegen die Queue und für oder gegen Lizenzkosten.
- Architekt und PO legen gemeinsam die Metriken für den Betrieb fest. Der Architekt sagt, was gemessen wird, der PO, was als akzeptabel gilt.
- Die KI setzt um, eine zweite KI prüft, und im Betrieb beobachtet die KI die Metriken.
- Ein benannter Mensch gibt frei.
Offen bleibt der Nachwuchs. In «Die KI ersetzt nicht die Juniors» habe ich geschrieben, dass sich die wichtigste Kompetenz eines Entwicklers vom Code schreiben zum Code beurteilen verschiebt. Liest niemand mehr den Code, verschiebt sie sich ein zweites Mal, zum Beurteilen von Spezifikation, Tests und Architektur. Wie man das lernt, ohne je selbst Code geschrieben oder gelesen zu haben, beantwortet dieses Modell nicht.
Die Grundlage
Vier dieser Guardrails tragen alle anderen: eine ganz genaue Spezifikation, gute Schnittstellenbeschreibungen, ein klares Bild des Tech Stacks und eine gute Testabdeckung. Stehen die, kann das durchaus funktionieren.
Keine dieser vier ist Code.
Wenn du gerade festlegst, wie viel Autonomie die KI in deiner Entwicklung bekommt und welche Guardrails dafür fehlen, buch unten einen Termin. Ich gebe dir eine Einschätzung.