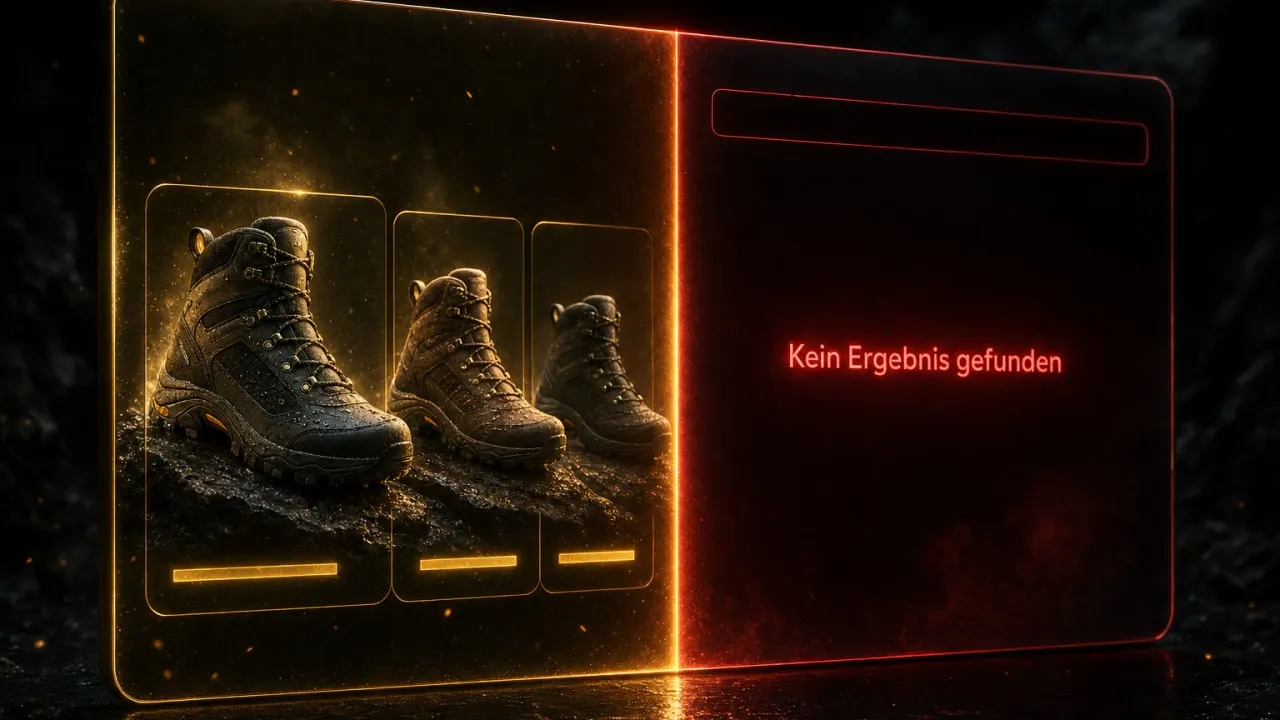
Ein Kunde tippt in eure Suche: "robuste Schuhe für nasse Bergtouren, Grösse 44."
Null Treffer.
Dabei habt ihr 800 davon im Lager.
Der beste Schuh dafür heisst bei euch "Meindl Bhutan MFS GTX". Kein einziges Wort aus der Anfrage kommt im Produktnamen vor. Also findet die Suche nichts. Der Kunde geht. Ihr hattet ihn im Lager und habt ihn trotzdem verloren.
In einem guten Fachgeschäft passiert das nie.
Da hört ein erfahrener Verkäufer "nasse Bergtouren" und geht ohne Umweg zum richtigen Regal. Er weiss: nass heisst Membran, nicht nur imprägniert. Er weiss, dass Meindl genau dafür baut. Er weiss, dass zur Bergtour ein knöchelhoher Schnitt und eine griffige Sohle gehören.
Nichts davon steht auf dem Schuhkarton.
Und genau das ist das Problem. Nicht die Suche. Das Wissen.
Mehr KI auf das Problem zu werfen, macht es nicht besser
Der Reflex ist immer derselbe: grösseres KI-Modell, "KI-Suche" über den ganzen Katalog, fertig.
Das war absehbar zum Scheitern verurteilt. Hier ist der ehrliche Grund.
Die klassische Suche vergleicht Wörter. "Nasse Bergtour" trifft im Namen "Meindl Bhutan GTX" exakt null Wörter. Kein Match, kein Treffer.
Die KI-Bedeutungssuche (oft Vektorsuche genannt) klingt nach der Lösung. Sie versteht Bedeutung statt Buchstaben. Nur rät sie Zusammenhänge aus Ähnlichkeit. Und da liegt die Falle.
Für die KI klingen "wasserdicht" und "wasserabweisend" fast gleich. Die beiden Begriffe liegen für sie direkt nebeneinander. Genau der Unterschied, an dem im Regen trockene Füsse hängen, verschwimmt der KI zu einem Brei.
Und das Grundproblem bleibt: Die KI kann nicht wissen, was nie jemand aufgeschrieben hat. Das Wissen des Verkäufers stand in keinen Daten.
KI beantwortet die Frage "welcher Text sieht ähnlich aus". Sie beantwortet nicht die Frage "wie hängt das zusammen".
Die fehlende Schicht: das Wissen des Verkäufers, aufgeschrieben
Der Schritt, den fast alle überspringen: das Wissen über die Produkte als eigene Schicht bauen. Getrennt vom Katalog.
Nicht "was kostet dieser Schuh und ist er auf Lager" (das ist der Katalog). Sondern "was bedeutet wasserdicht, wozu gehört eine Bergtour, welche Marke steht wofür" (das ist das Wissen).
Dafür gibt es seit Kurzem ein offenes Format von Google: das Open Knowledge Format, kurz OKF (Juni 2026). Kein Produkt, keine Plattform, kein Abo. Im Kern ist es nur eines: ein Ordner mit einfachen Textdateien.
Eine Datei ist ein Konzept. "Wasserdicht" ist eine Datei. "Wanderschuh" ist eine Datei. "Meindl" ist eine Datei. Und die Dateien verweisen aufeinander. Diese Verweise sind das Wissensnetz (der Knowledge Graph).
So sieht so ein Baustein aus, stark vereinfacht:
Baustein: WASSERDICHT
Bedeutung: Membran hält Wasser komplett ab.
            Das ist NICHT dasselbe wie wasserabweisend.
Gehört zu: Membran, Nasswetter
Verweist: → wasserabweisend (nur Imprägnierung, keine Membran)
            → Meindl, GORE-TEX, SympaTex
Drei Dinge arbeiten hier zusammen, und erst zusammen ergeben sie die extrem guten Ergebnisse:
Das Format (OKF) hält das Wissen fest, in lesbaren Dateien, die jeder Mensch und jede Maschine versteht.
Das Wissensnetz (Knowledge Graph) verbindet die Bausteine. "Nasse Bergtour" führt über "Wanderschuh" zu "wasserdicht" zu "Membran" zu den passenden Marken. Genau die Gedankenkette des Verkäufers.
Die Bedeutungssuche (Vektorsuche) findet den Einstieg. Sie erkennt, dass "nasse Bergtour" beim Baustein "Wanderschuh" und "wasserdicht" landet, auch wenn der Kunde diese Wörter nie tippt.
Der entscheidende Schnitt: zwei Schichten, nicht eine
Hier machen es die meisten falsch. Sie kippen alle drei Millionen Artikel in die KI und hoffen.
Trennt stattdessen sauber:
Die Katalog-Schicht: drei Millionen Artikel. Ändert sich stündlich (Preis, Bestand). Läuft maschinell. Das ist das Lager voller Schuhe.
Die Wissens-Schicht: rund 5000 gepflegte Bausteine. Stabil. Von Menschen geprüft. Das ist das Hirn des erfahrenen Verkäufers.
5000 Bausteine sind eine Grösse, die ein Team wirklich betreuen kann. Drei Millionen sind es nicht.
Wie die Suche dann läuft
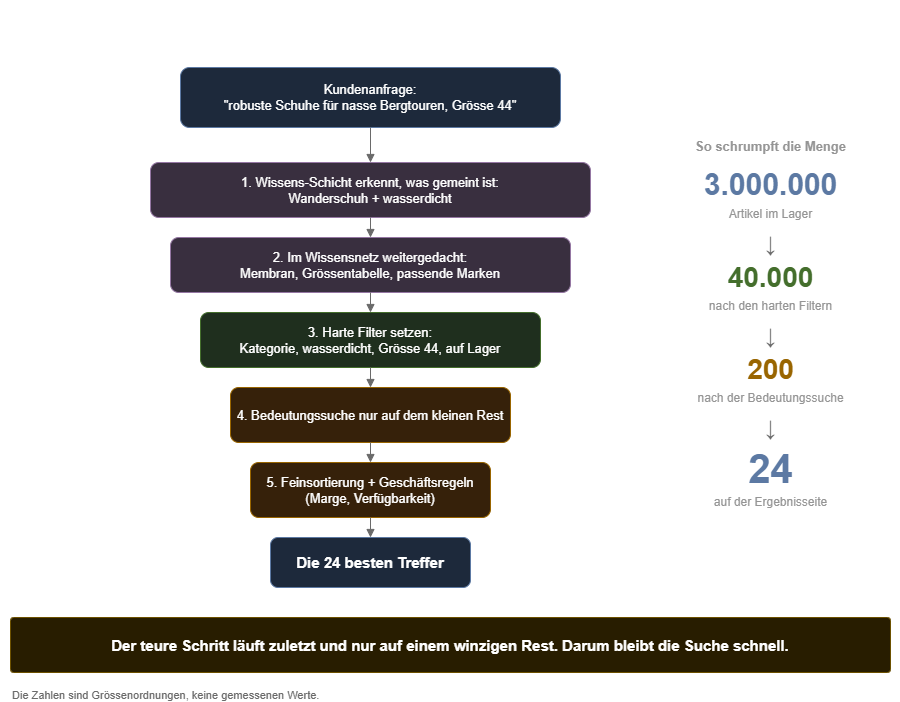
Die Reihenfolge wird umgedreht. Nicht zuerst durch drei Millionen Artikel wühlen, sondern:
Zuerst fragt das System die Wissens-Schicht: Was will dieser Kunde überhaupt? Antwort: Wanderschuh, wasserdicht. Diese Frage läuft gegen 5000 Bausteine, nicht gegen drei Millionen Artikel.
Dann folgt es den Verweisen im Wissensnetz: wasserdicht führt zu Membran, Bergtour führt zur Grössentabelle, dazu die passenden Marken. Die Assoziationen des Verkäufers, in Sekundenbruchteilen.
Daraus leitet das System harte Filter ab: Kategorie Wanderschuh, wasserdicht ja, Grösse 44, auf Lager. Allein das schrumpft drei Millionen Artikel auf einige Zehntausend.
Erst jetzt läuft die teure Bedeutungssuche, aber nur noch auf diesem kleinen Rest.
Zum Schluss die Feinsortierung: Relevanz plus eure Geschäftsregeln (Marge, Verfügbarkeit).
Und wenn die Wissens-Schicht einmal ausfällt, fällt das System auf die normale Suche zurück. Langsamer, aber nie eine leere Ergebnisseite. (Die genannten Grössenverhältnisse sind Grössenordnungen aus der Architektur, keine gemessenen Benchmarks.)
Die Wissens-Schicht ist kein zusätzlicher Umweg. Sie ist ein Präzisions-Verstärker: Sie kostet ein bisschen und spart sehr viel, weil die teure KI-Suche nur noch einen winzigen Bruchteil durchsehen muss.
Der Betriebsvorteil, über den keiner redet
Drei Dinge, die im Alltag den Unterschied machen.
Preis und Bestand ändern sich stündlich. Die gehen direkt in den Katalog, die KI muss dafür nichts neu einlesen.
Das Wissen ändert sich vielleicht wöchentlich. Ändert jemand einen Baustein, wird nur dieser eine neu verarbeitet. Sekunden statt Stunden.
Und der eigentliche Knaller: Wenn jemand festlegt "wasserdicht heisst Membran, nicht nur Imprägnierung", ist das eine dokumentierte, geprüfte, rückgängig machbare Änderung. Mit Verlauf. Mit Freigabe. Wie eine saubere Software-Änderung.
Vergleicht das mit dem heutigen Zustand: ein anonymer Eintrag in einer Synonymliste, den vor 18 Monaten jemand gemacht hat, der nicht mehr in der Firma ist, und niemand traut sich, ihn anzufassen.
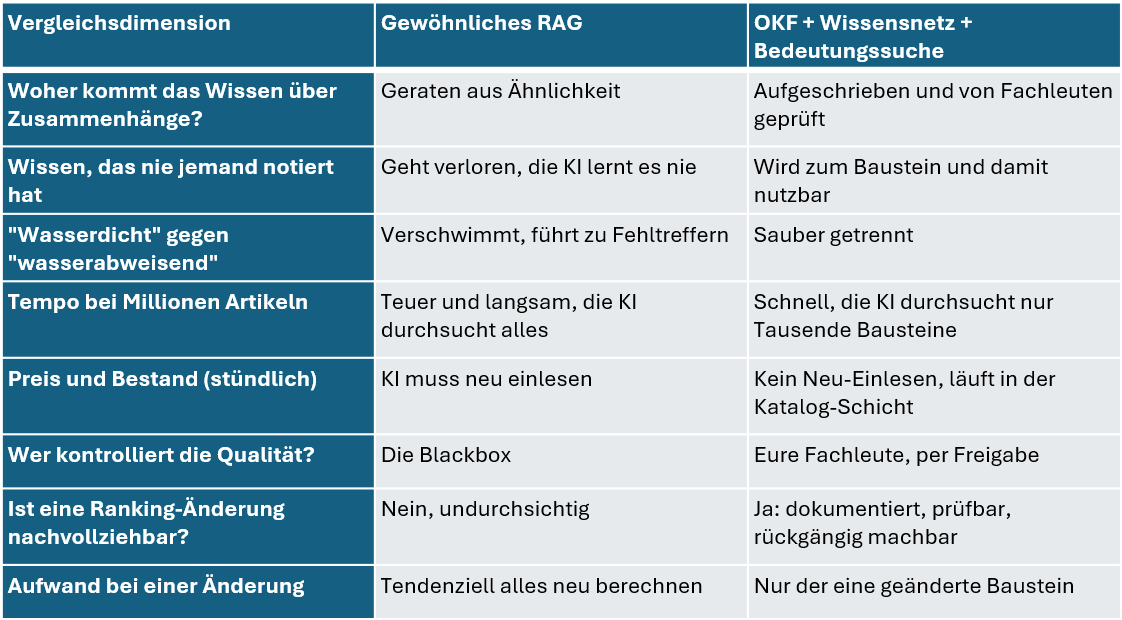
Gewöhnliches RAG gegen OKF plus Wissensnetz plus Bedeutungssuche
Kurz zur Einordnung: "RAG" ist der übliche Weg, einer KI Zugriff auf eure Daten zu geben. Man kippt die Inhalte in eine Bedeutungssuche und lässt die KI das Ähnlichste heraussuchen. Das ist der Standard. Und hier ist, wo er gegen den beschriebenen Ansatz verliert.
"Aber wer pflegt 5000 Dateien?" Niemand. Die KI erzeugt sie.
Der berechtigte Einwand: 5000 Dateien von Hand schreiben, das schafft kein Team.
Stimmt. Und das soll auch niemand. Das wäre so absurd, als müsste der erfahrene Verkäufer vor seinem ersten Arbeitstag eigenhändig ein Lexikon schreiben.
Das Rohmaterial habt ihr längst. Die KI baut den Erstentwurf. Menschen geben frei, worauf es ankommt.
Die Daten, die ihr schon habt (und in denen das Wissen versteckt liegt):
Euer Kategoriebaum und eure Attribute. Das ist das Skelett, schon strukturiert. "Wanderschuh" und "wasserdicht" existieren bei euch längst als Filter.
Eure Produktdaten und Herstellerangaben. Die GORE-TEX-Angabe von Meindl sagt euch schwarz auf weiss, dass es eine Membran ist.
Eure Bewertungen und Retouren. Kunden schreiben wörtlich "dachte, der wäre wasserdicht, Füsse waren nass". Das ist die Verwechslung wasserdicht gegen wasserabweisend, dokumentiert von euren eigenen Kunden.
Eure Suchprotokolle, vor allem die Suchen mit null Treffern. Das ist das Gold. Jede erfolglose Suche nach "robuste Schuhe für nasse Bergtouren" ist ein fehlender Baustein, benannt in den Worten des Kunden.
Eure vorhandenen Kaufberatungen und Ratgebertexte.
Und ja, die alten Synonymlisten. Die werden zu sauberen Bausteinen.
Wie die Daten aufbereitet werden müssen:
Vereinheitlichen: "wasserdicht", "wdicht", "GORE-TEX", "waterproof" zeigen auf einen Baustein, nicht auf vier.
Entdoppeln und den Kategoriebaum sauber ziehen.
Den Katalog nach Mustern gruppieren, damit die natürlichen Konzepte sichtbar werden.
Wie die Architektur aussieht (eine KI-Veredelungs-Strecke):
Die KI liest alle Quellen und schreibt Erstentwürfe der Bausteine: die Beschreibungen, und sie schlägt die kritischen Unterscheidungen vor ("wasserdicht ist nicht wasserabweisend"), markiert zur Prüfung.
Die KI schlägt die Verweise zwischen den Bausteinen vor. Das ist das Wissensnetz, automatisch gesponnen.
Jeder Schwung kommt als Vorschlag zur Freigabe, wie eine Änderung, die jemand absegnet. Eine Fachperson prüft und gibt frei. Nicht schreibt. Prüft.
Und dann läuft es weiter. Jede neue Null-Treffer-Suche wird zum Kandidaten für einen neuen Baustein. Das System sagt euch selbst, welches Wissen ihm noch fehlt.
Die Aufteilung ist der ganze Trick. Die KI macht die 90 Prozent (entwerfen, verknüpfen, gruppieren, die Protokolle auswerten). Der Mensch macht die 10 Prozent, die wirklich Urteilskraft brauchen (ist wasserdicht für unsere Bergkunden wirklich etwas anderes als wasserabweisend? Ja). Genau diese 10 Prozent sind euer Vorsprung, den kein Wettbewerber einfach kopiert.
Ihr schreibt kein Lexikon. Ihr gebt eines frei, das eure eigenen Daten längst geschrieben haben.
Ein Aufbau, mehrfacher Nutzen
Das Schönste kommt zum Schluss. Diese Wissens-Schicht arbeitet nicht nur für die Suche.
Derselbe geprüfte Wissensbestand erdet auch euren Chatbot, damit er aufhört, Unsinn zu erfinden, und stattdessen aus eurem echten Wissen antwortet. Er speist die Kaufberatung. Er trägt die Produktempfehlung.
Ihr baut das Hirn eures besten Verkäufers einmal. Danach arbeitet es überall, wo ein Kunde eine Frage hat.
Die ehrliche Einschränkung
Damit das hier Analyse bleibt und nicht Werbung:
Die Wissens-Schicht ist Arbeit, die am Anfang anfällt. Gibt niemand die Bausteine frei, habt ihr einen leeren Ordner und ein ganz normales KI-Setup. Die Arbeit verschwindet nicht, sie wandert nur dahin, wo sie hingehört: zu euren Fachleuten.
Das Format ist jung (Version 0.1, noch Entwurf). Ein paar Dinge sind bewusst offen.
Und der wichtigste Punkt: Die KI entwirft, aber die Entscheidung "wasserdicht ist für unsere Kunden etwas anderes als wasserabweisend" ist eine Geschäftsentscheidung, keine Rechenaufgabe. Das ist keine Schwäche. Das ist der Grund, warum es funktioniert.
Die eigentliche Frage
Die Frage ist nicht, ob euer KI-Modell gross genug ist.
Die Frage ist, ob jemals irgendwer aufgeschrieben hat, was euer Modell wissen müsste.
Euer bester Verkäufer wusste es. Er hat es nur nie aufgeschrieben. Jetzt könnt ihr es.
Eine Frage zum Schluss, weil sie fast überall den wunden Punkt trifft: Wer pflegt bei euch eigentlich die Synonymliste, und weiss diese Person, dass sie damit euer Ranking steuert?