Die Zahl, mit der Wissensmanagement verkauft wird, gibt es nicht.
Du kennst sie: Das Menschheitswissen verdoppelt sich alle zwölf Stunden. Die Behauptung wird auf einen IBM Report zurückgeführt. Diesen Report hat nie jemand vorgelegt. Die Spur endet in einem Blogartikel von 2013, der auf «ein IBM Papier» verweist, ohne Titel, ohne Datum, ohne Link. Buckminster Fuller wird als Urheber der Kurve genannt, die zwölf Stunden hat er nie gesagt.
Was sich tatsächlich messen lässt, ist die Menge wissenschaftlicher Publikationen. Bornmann, Haunschild und Mutz haben 2021 vier Literaturdatenbanken über den Zeitraum ab 1675 ausgewertet. Ergebnis: 4.10 Prozent Wachstum pro Jahr, eine Verdopplung alle 17.3 Jahre. Seit 1952 sind es 5.08 Prozent, eine Verdopplung alle 14 Jahre. In der Phase vor der Industrialisierung dauerte dieselbe Verdopplung 24.5 Jahre.
Das klingt zahmer als zwölf Stunden. Ist es nicht. Rechne es auf ein Berufsleben um: 40 Jahre bei 5.08 Prozent sind Faktor sieben. Wer heute in Pension geht, hat miterlebt, wie sich der Bestand an wissenschaftlicher Literatur mehr als versiebenfacht hat. Deine Aufnahmefähigkeit ist im selben Zeitraum exakt gleich geblieben.
Und das ist nur der Teil, der gezählt wird. Publikationen sind nicht Wissen, sie sind das, was jemand indexiert hat. Alles, was dein Unternehmen weiss, taucht in keiner dieser Datenbanken auf.
Das Problem ist nicht die Menge. Es ist der Ort.
Wissen liegt bei euch quer verstreut. In KI-Chats, in Slack, in Teams, in Confluence, in Jira, in zwei weiteren Wikis, in Dokumenten auf dem Shared Drive, in SharePoint, in PowerPoints, die jemand vor drei Jahren für ein Steering gebaut hat.
Jede dieser Ablagen enthält eine Sicht auf die Wahrheit. Einen Teilausschnitt, aus der Perspektive des Autors, zum Zeitpunkt des Schreibens. Nicht falsch, aber auch nicht vollständig, und für die meisten Kolleginnen und Kollegen schlicht nicht auffindbar.
Nimm Meeting Minutes. Meine Erfahrung nach vielen Jahren in Projekten: Minutes entstehen bei etwa jedem dritten Meeting, und wenn sie entstehen, gehen sie exakt an den Teilnehmerkreis. Kündigt morgen jemand und fängt übermorgen jemand Neues an, ist diese Information weg. Sie liegt in einer Mailbox, die niemand mehr durchsucht, oder in einer, die deaktiviert wurde.
Minutes sind nur so lange wertvoll, wie jemand, der dabei war, sie wieder hervorkramt und sich darauf berufen kann. Ist diese Person nicht mehr im Unternehmen, verliert die Information ihre Bedeutung. Das Wissen ist nicht gelöscht. Es ist unerreichbar, und das ist praktisch dasselbe.
Slack ist dasselbe Muster in schneller. Hast du schon einmal einen Slack-Channel zwei Jahre zurückgespult? Eben. Alles, was über «machst du das oder soll ich» hinausgeht, also Implementierungsdetails, Investitionsabsprachen, die Begründung, warum ihr euch gegen die andere Variante entschieden habt, ist damit verloren.
Jetzt kommt der übliche Einwand: Diese Informationen verlieren doch mit der Zeit an Wert. Stimmt, die Information selbst schon. Die Herleitung nicht. Entscheidungen bauen auf Entscheidungen auf. Wenn niemand mehr rekonstruieren kann, warum etwas so ist, bekommst du auf jede Warum-Frage dieselbe Antwort: Ist so, weil ist so.
Das ist der Moment, in dem ein Unternehmen anfängt, seine eigenen Altlasten für Naturgesetze zu halten.
«Wir haben ein Wiki. Da schaut nur keiner rein.»
Diesen Einwand höre ich zu Recht. Wikis sind der klassische Ort, an dem Wissen stirbt: 400 Seiten, die Hälfte veraltet, die Suche findet nichts, also fragt man wieder den Kollegen. Ein weiteres Tool löst das nicht.
Drei Dinge sind heute anders.
Erstens die Indexierung. Berechtigungen sind nicht das Unterscheidungsmerkmal, die hat jedes Fileshare. Auf dem S-Drive kannst du sauber steuern, wer welchen Ordner sieht. Nur ist der Inhalt dort nicht indexiert. Du suchst nicht nach einer Aussage, sondern nach einem Dateinamen, und im besten Fall öffnest du danach zwanzig Dokumente, um die eine Zeile zu finden, die du brauchst. Was in der Geschäftsleitungssitzung besprochen wird, darf nicht jeder lesen, verloren gehen soll es trotzdem nicht, und für die Berechtigten muss es auffindbar sein. Erst diese Kombination aus Zugriffssteuerung und indexiertem Inhalt ist der Unterschied. Confluence bildet sie über Spaces und Seitenbeschränkungen ab.
Zweitens die Suche. Der Grund, warum niemand ins Wiki schaut, war nie die Ablage, sondern das Wiederfinden. Eine KI, die in natürlicher Sprache antwortet und dabei nur Inhalte verwendet, auf die du ohnehin Zugriff hast, dreht das um. Bei Atlassian heisst das Rovo, und die Berechtigungstreue ist dokumentiert. Das ist eine Herstelleraussage, also prüf sie in deinem eigenen Tenant, bevor du dich darauf verlässt. Prüf sie unbedingt, denn hier liegt das eine echte Risiko: Wenn die Suche still schweigt statt «dazu gibt es etwas, du darfst es nicht sehen» zu sagen, glaubt der Neue, es gäbe nichts.
Drittens, und das ist der eigentliche Punkt: Das Befüllen war früher Handarbeit. Deshalb ist es nie passiert.
Warum das jetzt geht
Der übliche Reflex lautet: Das initial aufzusetzen ist wahnsinnig viel Arbeit.
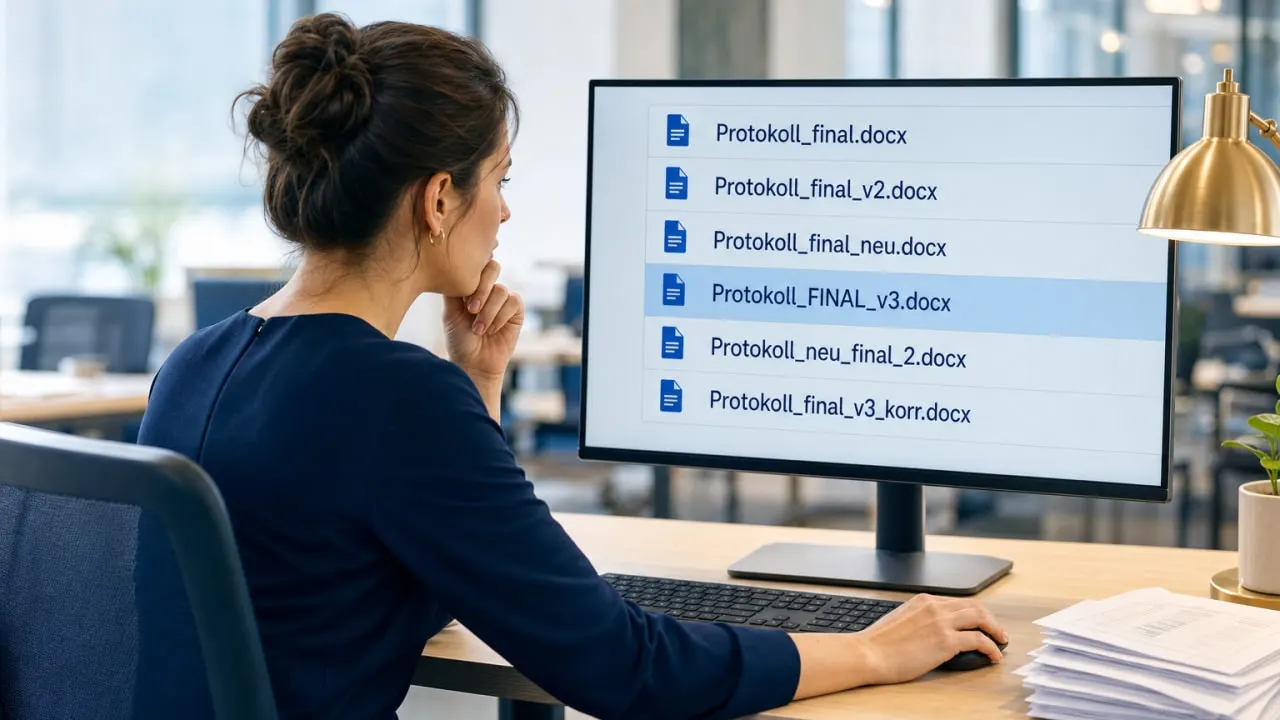
Sieht so aus. Ist es aber nicht mehr, denn die Arbeit besteht aus genau dem, was Sprachmodelle können: grosse Mengen bestehender Texte durchgehen, pro Thema konsolidieren und sauber aufbereitet aufschreiben. Die alten Informationssenken durchsuchen, Dubletten zusammenführen, aus fünf Fassungen einer Absprache eine Seite machen.
Zwei Stellen bleiben beim Menschen, und beide sind nicht verhandelbar.
Widersprüche löst der Mensch auf. Wenn drei Quellen drei verschiedene Dinge sagen, entscheidet nicht das Modell, welche gilt. Das Modell legt den Widerspruch offen, jemand mit Verantwortung entscheidet.
Jede Aussage behält ihre Herkunft. Konsolidierung ohne Quellverweis ist kein Wissen, sondern ein selbstbewusst formulierter Text. Wenn die Seite später bestritten wird, musst du zur ursprünglichen Mail, zum ursprünglichen Thread zurückkommen können.
Pro Abteilung ein Space, darunter eine Struktur, darin Seiten mit Querverweisen und einer Eigentümerin oder einem Eigentümer pro Seite. Erst wenn ein Thema drin ist, wird die alte Quelle abgeschaltet. Und bevor du irgendetwas löschst: Aufbewahrungspflichten prüfen. Konsolidieren heisst nicht entsorgen.
Sonst ist es eine Einmalaktion
Ein konsolidierter Space verfällt, wenn er nicht weitergeführt wird. Nach zwölf Monaten ist er wieder das tote Wiki, gegen das du angetreten bist. Deshalb ist der Aufräumteil der kleinere Teil des Projekts.
Der grössere Teil sind die Prozesse drumherum. Das Meeting wird künftig direkt in Confluence abgelegt, von der KI, in der richtigen Struktur, mit den richtigen Berechtigungen. Damit stellt sich die Frage nicht mehr, wer die Minutes schreibt und ob es überhaupt welche gibt. Der Entscheid ist dort, wo er hingehört, samt Herleitung.
Und der neue Mitarbeiter arbeitet in der ersten Woche den Space seiner Abteilung durch, statt in vier Wochen dieselben zwölf Fragen an dieselben drei Leute zu stellen.
Zum ROI
Ich könnte dir jetzt schreiben, dass sich das in unter einem Jahr rechnet. Das behaupten alle, und niemand legt die Rechnung offen. Also mach sie selbst, sie ist simpel: Die Investition ist einmalig und in Personentagen messbar. Der Nutzen ist wiederkehrend und liegt in Suchzeit, in Einarbeitungszeit und in Entscheidungen, die nicht ein zweites Mal getroffen werden müssen.
Wenn du diese drei Grössen in deinem Unternehmen nicht beziffern kannst, hast du kein ROI-Problem, sondern ein Messproblem. Dann fang damit an.
Das ist der erste KI-Anwendungsfall, der wirklich etwas verändert, und er geht deutlich über «wir machen jetzt mal was mit KI» hinaus. Er ist nachhaltig, er ist messbar, und er wäre von Hand praktisch unmöglich gewesen. Deshalb hat ihn bisher niemand gemacht.