Wer KI-Systeme betreibt, muss nachvollziehen können, was gepromptet wurde, was die KI geantwortet hat und was es gekostet hat. Fehlt einer dieser drei Punkte, verlierst du die Kontrolle.
Die erste Ebene gehört Microsoft
Logging gibt es auf mehreren Ebenen. Bei Microsoft Foundry liefert Microsoft die erste automatisch mit: das Abuse Monitoring. Damit prüft Microsoft, ob die KI entgegen den Produktbedingungen eingesetzt wird. Das ist Segen und Fluch zugleich. Solange du die KI intern nutzt, ist alles einfach. Sobald aber deine Kunden das System nutzen, trägst du auch deren Eingaben. Missbraucht ein einziger Kunde die KI, kann Microsoft den Zugang drosseln oder die ganze Subscription sperren. Dann fehlt allen anderen Kunden die Funktion, und dir fehlt der Umsatz. Mit dem Monitoring prüfen im Verdachtsfall Menschen, bevor gesperrt wird. Der Preis dafür: Microsoft verarbeitet deine Anfragen und Antworten, und bei einem Verdacht können Microsoft-Mitarbeitende sie einsehen. Auf der anderen Seite steht also der Datenschutz.
Microsoft bietet ein Formular an, mit dem du eine Änderung des Abuse Monitorings beantragen kannst. Wird sie genehmigt, speichert Microsoft Anfragen und Antworten nicht mehr, und niemand sieht sie sich an. Eine automatische Prüfung läuft laut Microsoft trotzdem weiter. Wer das Monitoring abschaltet, ist vor einer Sperre nicht geschützt: Die automatische Prüfung kann laut Microsoft weiterhin zu Einschränkungen führen, nur prüft dann kein Mensch mehr, bevor sie greifen. Ob der Antrag durch ist, siehst du in der JSON-Ansicht der Ressource: Dort steht dann ContentLogging auf false.
Für die Kontrolle über deine eigene Anwendung taugt dieses Monitoring nicht. Die geloggten Daten kann auch dein Azure-Administrator nicht einsehen. Hier musst du selbst etwas tun.
Welche Plattform?
Zuerst brauchst du eine gute Logging-Plattform. Ich habe über die Jahre einige ausprobiert. Die Produkte haben einen unterschiedlichen Leistungsumfang, und ich habe in Teams erlebt, dass dann zwei oder drei Logging-Senken für verschiedene Anwendungsfälle nebeneinander liefen, mit den entsprechenden Kosten fürs Projekt. Deshalb bevorzuge ich ein Verbundsystem: Logging, Tracing, Profiling und Metriken an einem Ort, in Dashboards aufbereitet und über den offenen Standard OpenTelemetry beliefert.
An diesem Anspruch habe ich die Anbieter gemessen, die ich kenne. Die Preise sind Listenpreise vom 30. September 2026 in US-Dollar, wo möglich für die Schweiz.
| Anbieter | Logs, Metriken, Traces, Profiling | OpenTelemetry | KI-Aufrufe erfassen | Selbst betreibbar | Log-Preis | Einschätzung |
|---|---|---|---|---|---|---|
| Grafana Cloud | alle vier | nativ | ja: Prompts, Token, Kosten, Tool Calls | ja, Open Source | 0.45 USD/GB plus 0.10 USD/GB Aufbewahrung, 50 GB gratis | Alles in einem System, offen, günstig. Dashboards und Abfragen erstellt die KI |
| Datadog | alle vier | ja | ja: Prompts, Token, Kosten | nein | 0.10 USD/GB plus 1.70 USD pro Million indexierte Events; APM 31 USD pro Host und Monat | Funktional am nächsten, aber viele Einzelprodukte pro Host, schwer planbar |
| New Relic | Logs, Metriken, Traces; Profiling nicht dokumentiert | nativ | ja: Requests, Responses, Token | nein | 0.40 USD/GB, 100 GB gratis; Pro-Benutzer 349 USD pro Monat | Gut, aber teuer pro Benutzer |
| Sentry | Fehler, Traces, Logs, Profiling; Metriken schwach | Traces und Logs, Beta | ja: Prompts, Token, Kosten, Tool Calls | ja | 0.50 USD/GB, ab 26 USD pro Monat | Stark bei Exceptions, schwach bei Metriken |
| Better Stack | Logs, Metriken, Traces; kein Profiling dokumentiert | ja | nur KI-Fehleranalyse | nein | 0.10 USD/GB plus 0.05 USD/GB pro Monat (Europa) | Günstigster GB-Preis, aber kein Profiling |
| Azure Application Insights | Logs, Metriken, Traces | über Microsoft-Distro | ja, Foundry-Tracing | nein | 3.29 USD/GB (Switzerland North), 5 GB gratis | Naheliegend in Azure, teuerster GB-Preis |
| AWS CloudWatch | Logs, Metriken, Traces | ja, nur HTTP | ja, Schwerpunkt Bedrock | nein | 0.69 USD/GB (Zürich); 0.30 USD pro Metrik und Monat | Naheliegend in AWS, viele Einzelpositionen |
| elmah.io | nur Fehler und Logmeldungen (.NET) | nicht dokumentiert | nein | nein | ab 26 USD pro Monat für 10'000 Meldungen | Nur Fehlerlogging |
| Stackify Retrace | wird am 31. März 2027 eingestellt | Keine Option mehr | ||||
Grafana ist mein Favorit, und ich empfehle es aktuell. Es ist das einzige System im Vergleich, das alle vier Signale abdeckt, KI-Aufrufe über OpenTelemetry erfasst und sich bei Bedarf auch selbst betreiben lässt. Datadog kommt funktional am nächsten heran, rechnet aber viele Produkte einzeln pro Host ab und lässt sich nicht selbst betreiben.
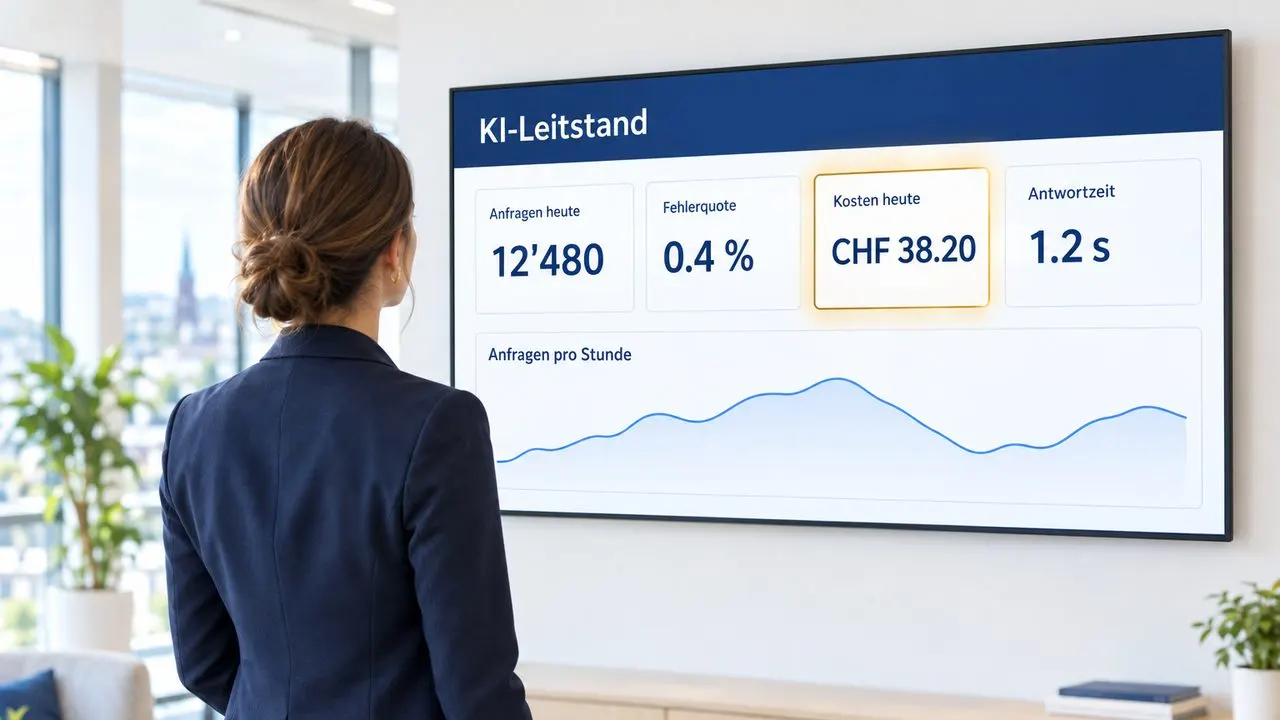
Die Hürde bei Grafana waren bisher die Abfragesprachen und Dashboards, die man von Hand zusammenbaut. Mit KI fällt diese Hürde weg. Das Leitstand-Dashboard für einen Kunden, auf dem ich die wichtigsten Metriken zur Systemstabilität im Blick behalte, hat Claude komplett erstellt. Ich prüfe die Ergebnisse, gebaut habe ich nichts davon selbst. Auch die Abfragen schreibe ich nicht mehr selbst. Ich sage Claude, welche Aspekte mich interessieren, und lasse sie analysieren.
Mit KI stellt sich die Frage neu, was geloggt werden soll und welches System sich dafür eignet. Die Tabelle gibt dir eine Grundlage, um das fundiert zu entscheiden.
Was du erheben musst
Request und Response sind klar, aber das reicht nicht. Diese Werte gehören für jeden KI-Aufruf ins Logging:
- Request
- Response
- Exceptions
- Anzahl Aufrufe des Modells
- Fehlerrate
- Dauer des Aufrufs
- Erfolgreiche Tool Calls
- Fehlerhafte Tool Calls
- Verbrauchte Token
- Gecachte Token
- Token-Kosten
Damit baust du ein KI-Dashboard, auf dem du siehst, wenn Fehlerquote oder Kosten aus dem Ruder laufen.
Unveränderlich oder wertlos
Damit Logging und Monitoring unanfechtbar bleiben, müssen sie nach dem Prinzip WORM aufgebaut sein: Write Once, Read Many. Deshalb schlage ich keine lokale Datenbank vor. Dort müsstest du die Einträge wie eine Blockchain verketten, damit jeder Eintrag den vorherigen absichert und du nachweisen kannst, dass hinterher nichts manipuliert wurde. Das Ziel ist, vor Gericht Nachweise erbringen zu können, wenn ein Kunde etwas behauptet.
Das kollidiert mit dem Datenschutz. Prompts und Antworten enthalten oft Personendaten, und die musst du auf Anfrage löschen können. Aus einem unveränderlichen Speicher geht das nicht. Ich löse das mit Hashwerten. Für jeden Request und jede Response berechnet die Anwendung einen Hash mit einem geheimen Schlüssel, einen sogenannten HMAC. Ohne den Schlüssel liesse sich eine kurze Antwort wie «Ja» durch Ausprobieren zurückrechnen.
In der WORM-Senke landet nur der Hash, zusammen mit Zeitpunkt, Modell, Token und Kosten. In Grafana liegen Request und Response im Klartext, verknüpft mit demselben Hash. Nach einer Löschanfrage entfernst du den Klartext in Grafana, im Archiv existiert nur noch der Hash. Kommt ein Kunde mit einer Datei, was der Chatbot gesagt haben soll, berechnest du den Hash neu und vergleichst ihn mit dem Archiv. Stimmt er überein, ist die Aussage samt Zeitpunkt belegt. Das funktioniert mit dem exakten Wortlaut, nicht mit einem Screenshot oder einer sinngemässen Wiedergabe.
So sieht das mit AWS S3 aus
- Ein S3-Bucket mit Versionierung und Object Lock im Compliance-Modus. Während der Aufbewahrungsfrist kann dort niemand einen Eintrag überschreiben oder löschen, laut AWS nicht einmal der Root-Benutzer des Kontos. Die Frist legst du einmal fest, verkürzen lässt sie sich danach nicht mehr.
- Die Anwendung berechnet die Hashwerte und schickt alle Daten per OpenTelemetry an einen Collector.
- Der Collector verteilt. Grafana bekommt alles, inklusive Klartext. Für das Archiv entfernt er den Klartext und schreibt nur Hash, Zeitpunkt, Modell, Token, Kosten und Fehler in den S3-Bucket.
- Bei einer Löschanfrage löschst du den Klartext in Grafana. Das Archiv bleibt unangetastet.
Alle Aspekte der Nachweisbarkeit von KI richtig umzusetzen, braucht viel Erfahrung und Know-how. Wenn du dabei Unterstützung brauchst, buch unten ein kostenloses Erstgespräch von 30 Minuten, und wir schauen gemeinsam, wo du stehst.