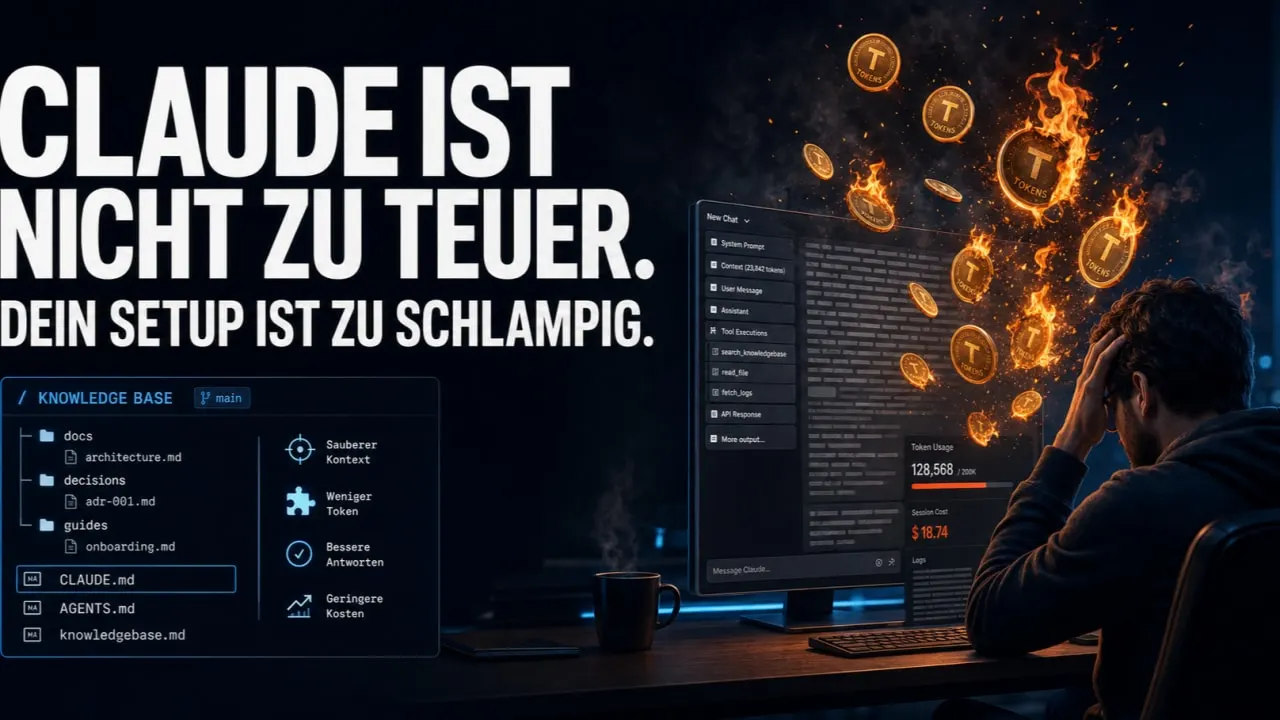
Unangenehme Wahrheit: Viele Teams jammern über KI-Kosten, aber füttern Claude Code, Codex und Co. jeden Tag mit ihrem organisatorischen Chaos.
Das Problem ist meistens nicht das Modell. Das Problem ist fehlendes Knowledge Management.
Wer regelmässig mit KI arbeitet, weiss: Kosten entstehen nicht durch Magie. Sie entstehen durch Tokens. Und Tokens entstehen durch Kontext.
Je mehr Chatverlauf, Dateien, Tool-Ausgaben, Logs und Wiederholungen Claude verarbeiten muss, desto teurer und langsamer wird die Arbeit.
Und genau hier beginnt das eigentliche Problem.
Viele Entwickler arbeiten an Aufgaben, die aufeinander aufbauen. Also bleibt man im gleichen Chat, weil man denkt:
„Wenn ich einen neuen Chat anfange, muss ich Claude ja wieder bei Adam und Eva abholen.“
Ja. Stimmt.
Aber wenn das wirklich nötig ist, hast du ein anderes Problem.
Dann steckt dein Projektwissen im Chatverlauf. Nicht im Code. Nicht in der Dokumentation. Nicht im Repository. Nicht im Team.
Sondern in einem temporären KI-Dialog.
Das ist kein professionelles Setup. Das ist digitales Bauchgefühl mit Token-Flatrate.
Stell dir eine einfache Frage:
Könnte ein Kollege deinen Task morgen übernehmen, ohne deinen Claude-Chat gelesen zu haben?
Wenn die Antwort nein ist, hast du kein KI-Problem. Du hast ein Knowledge-Management-Problem.
Und genau hier trennt sich Vibe-Coding von professioneller Softwareentwicklung.
Viele Teams haben punktuelle Lösungen. Ein README hier. Ein Confluence-Artikel dort. Ein paar Notizen in Slack. Vielleicht eine lokale Markdown-Datei auf dem Rechner eines Entwicklers.
Aber keine durchgängige, teamweite Strategie.
Das reicht nicht.
Der bessere Ansatz ist einfach:
Nach relevanten Aufgaben müssen die wichtigen Erkenntnisse zurück ins Projekt.
Nicht jeder Gedanke. Nicht jeder Prompt. Nicht jeder Zwischenschritt.
Aber alles, was für die nächste Aufgabe wichtig ist.
Zum Beispiel:
Architekturentscheidungen
technische Einschränkungen
API- und Datenmodell-Entscheidungen
bekannte Workarounds
Setup- und Deployment-Hinweise
offene Risiken
Folgeaufgaben
Dinge, die ein neuer Entwickler wissen muss
Besonderheiten, die Claude beim nächsten Task kennen sollte
Und jetzt kommt der entscheidende Punkt:
Diese Informationen gehören nicht nur in deinen Chatverlauf. Und auch nicht nur auf deinen lokalen Rechner.
Sie gehören ins Repository.
Als Markdown. Versioniert. Reviewbar. Teil des Projekts.
Zum Beispiel als:
CLAUDE.mdAGENTS.mdArchitecture Decision Records
docs/architecture/docs/ai-context/projektspezifische Implementation Notes
Damit wird Wissen nicht mehr in langen Chats versteckt, sondern zu einem echten Asset des Teams.
Das hat mehrere Effekte:
Jeder im Team kann Aufgaben leichter übernehmen.
Neue Chats können mit deutlich weniger Kontext gestartet werden.
Claude Code und Codex müssen nicht jedes Mal alles neu rekonstruieren.
Entscheidungen bleiben nachvollziehbar.
Architekturwissen bleibt im Projekt statt im Kopf einzelner Entwickler.
Das Kontextfenster bleibt kleiner.
Kosten und Laufzeiten sinken.
Die Qualität der KI-Ergebnisse steigt.
Natürlich ist das kein Freipass für Dokumentationsmüll.
Eine KI-generierte Knowledgebase darf kein unkontrollierter Dump sein. Sie muss kuratiert werden. Sie muss aktuell bleiben. Sie muss reviewed werden.
Und natürlich gehören keine Secrets, Zugangsdaten, personenbezogenen Daten oder sensiblen Interna unbedacht in solche Dateien.
Aber das Prinzip bleibt:
Wenn Claude etwas über eure Implementierung gelernt hat, das für spätere Arbeit relevant ist, dann darf dieses Wissen nicht im Chat sterben.
Es muss zurück ins Projekt.
Die einfache Regel lautet:
Alles, was ein Kollege für den nächsten Task wissen müsste, gehört nicht nur in den Chat, sondern ins Repository.
Das ist kein Overhead. Das ist Engineering Hygiene.
Und ja: Genau dadurch werden KI-Workflows günstiger.
Nicht weil Claude plötzlich weniger intelligent sein muss. Sondern weil du aufhörst, ihm jeden Tag denselben Kontext neu zu erklären.
KI-Kosten sind oft kein Tool-Problem. Sie sind ein Symptom für schlechte Projektorganisation.
Provokante Frage zum Schluss:
Wenn morgen ein neuer Entwickler in dein Projekt kommt: Findet er das relevante Wissen im Repository?
Oder müsste er erst deinen Claude-Chat lesen?