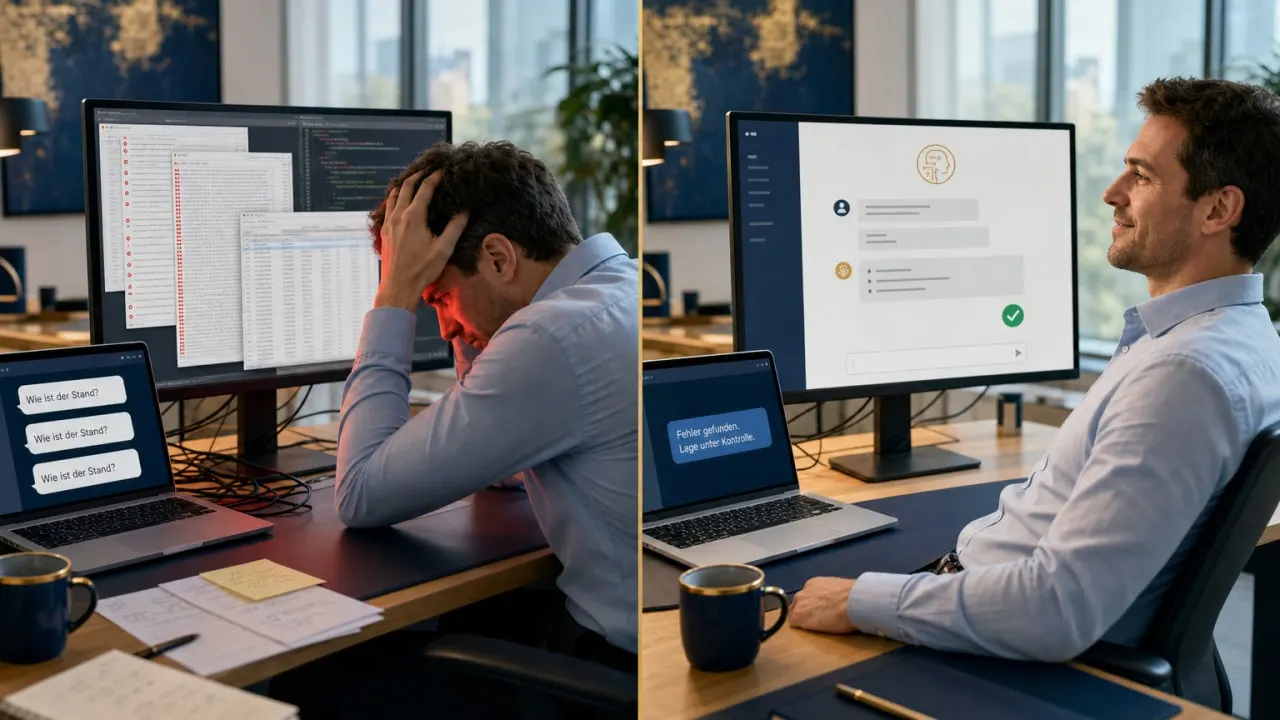
Nicht weil sie klüger wäre, sondern weil sie gleichzeitig sehen darf, was dein Team nacheinander zusammentragen muss. Was dieses Nacheinander kostet, weiss jeder, der schon einmal einen Produktionsfehler unter Kundendruck gejagt hat.
DevOps wühlt sich durch Berge von Logs, stellt Zusammenhänge her, korreliert Zeitstempel mit Code und Datenkonstellation. Unter Zeitdruck, weil eben etwas schief gegangen ist. Dann die Übergabe an die Entwicklung. Warten. Rückmeldung: nicht reproduzierbar. Kontext nachliefern. Warten. Analyse, Fix. Halber Tag im Eimer, und ein guter Teil davon war reine Latenz zwischen zwei Menschen, die denselben Fehler aus zwei verschiedenen Blickwinkeln betrachtet haben.
Diese Kette existiert nicht, weil Fehlersuche schwer ist. Sie existiert, weil das Wissen an drei Orten liegt: die Telemetrie bei DevOps, der Quellcode bei der Entwicklung, die auslösende Datenkonstellation in der Produktion. Keiner dieser Orte spricht mit den anderen. Der Mensch ist das Transportmittel dazwischen, und der Mensch ist langsam.
Was sich geändert hat, ist nicht das Modell
Konkretes Setup: Grafana für Logs, Metriken und Traces. Der Quellcode in exakt dem Stand, der aktuell deployed ist, nicht im Hauptzweig. Zugriff auf die Datenbank, in der das Szenario tatsächlich vorliegt. Und Claude Code als Agent darüber.
Der Punkt mit dem deployten Stand ist der, an dem klassische Reproduktionsversuche am häufigsten scheitern. Der Entwickler debuggt gegen den Code von heute, der Fehler ist im Code von vorletzter Woche passiert. Genau diese Korrelation, über drei Systeme und einen Zeitversatz hinweg, ist die Aufgabe, für die eine Maschine gebaut ist und ein Mensch nicht.
Der Ablauf
DevOps gibt dem Agenten die Fehlermeldung. Ab da läuft die Analyse autonom:
- Fehlerstelle finden. Der Agent sucht den Vorfall in Grafana, über eine angemeldete Session oder ein API-Token, und arbeitet sich vom Symptom über Trace und Korrelation zur auslösenden Anfrage vor.
- Reproduzieren. Er zieht die Datenkonstellation, die das Verhalten erzeugt hat, und giesst sie in einen Test, der den Fehler zuverlässig auslöst. Ab diesem Moment ist der Fehler kein Bericht mehr, sondern ein roter Balken.
- Ursache lokalisieren. Mit dem produktiven Kontext und dem passenden Quellcode findet er die Stelle, die den Fehler auslöst.
- Fix vorschlagen und belegen. Der Test zeigt, dass der Fix greift. Danach bleibt er als Regressionstest liegen, statt mit dem Ticket zu verschwinden.
Der ganze Block dauert Minuten, nicht Stunden. Und die Kategorie «nicht reproduzierbar» verschwindet, weil der reproduzierende Test Teil der Analyse ist und nicht ihr Ergebnis.
Während der Mensch den Fix prüft, schreibt der Agent die Root-Cause-Analyse für den Kunden. Er hat als Einziger den vollständigen Kontext dafür im Kopf, den ein Mensch sonst hinterher mühsam rekonstruiert.
Was der Mensch behält
Alles, was Konsequenzen hat.
Das Review des Fixes. Den Commit. Das Hotfix-Deployment. Die Freigabe der Root-Cause-Analyse, bevor sie an den Kunden geht, weil dein Name darunter steht und nicht der eines Modells. Und das Aufräumen der temporären Zugänge danach.
Der eigentliche Gewinn steckt in der Zeit dazwischen. Bisher war die Person, die den Stakeholdern erklären könnte, was los ist, exakt dieselbe Person, die gerade bis zum Hals in den Logs steckt. Kommunikation blieb liegen, und zwar immer genau dann, wenn sie am dringendsten gebraucht wurde. Diese Kollision löst sich auf, sobald das Heavy Lifting parallel läuft.
Die Zugriffsfrage, an der es meistens scheitert
Ein Agent, der Produktionsdaten sieht, ist ein Zugriff wie jeder andere und gehört behandelt wie einer. Vier Punkte reichen:
Ein eigener technischer Account, nicht die Credentials eines Menschen. Lesend, gescopt auf genau die Quellen, die der Vorfall braucht. Befristet auf die Dauer des Vorfalls und danach widerrufen. Und weil es ein eigener Account ist, steht im Audit-Log hinterher, was angefasst wurde.
Der zweite Teil der Antwort ist unbequemer. Was der Agent lesen darf, verlässt deine Umgebung, sobald es in seinem Kontext landet. Die Auswahl der Daten ist damit selbst eine Entscheidung und keine Nebensache. Eine Konstellation, die einen Fehler zeigt, braucht in aller Regel keine Klarnamen dazu. Wer diese Frage einmal sauber beantwortet, hat sie für jeden weiteren Vorfall beantwortet.
Die verbreitete Alternative ist, MCP-Server, API-Zugänge und Agenten pauschal zu sperren. Das ist die einzige Variante, die garantiert nichts bringt und trotzdem etwas kostet. Der Nutzen fällt vollständig weg, das Risiko bleibt, weil deine Leute die Werkzeuge privat weiterbenutzen, nur ohne dein Log.
Warum ausgerechnet dieser Use Case trägt
«KI produziert nur Prototypen» ist ein berechtigter Einwand. Er stimmt überall dort, wo man KI auf offene Probleme wirft. Ein Incident ist das exakte Gegenteil eines offenen Problems:
Die Erwartung ist definiert. Das Fehlverhalten ist beobachtbar. Der Erfolg ist binär prüfbar, rot oder grün. Der Kontext ist vollständig verfügbar, wenn man die Zugänge gewährt.
Diese vier Eigenschaften sind das Auswahlkriterium. Nicht die beeindruckendste Demo, sondern der Ablauf, bei dem eine Maschine ihr eigenes Ergebnis nachweisen kann. Wer nach Use Cases sucht, sucht nach genau diesem Muster, stellt dafür die Werkzeuge bereit und schult die Leute darin. Der Rest ist Theater.
Die Maschine trägt die Last, der Mensch trägt die Verantwortung. Wer diese Reihenfolge umdreht, bekommt am Ende beides nicht.